Como um fluxo de automação noturno com LLM local me poupou horas
Executar o Qwen 3.5 9B localmente via n8n para processar e-mails e tarefas todas as noites cria um briefing matinal útil sem a necessidade de comandos manuais no chat.
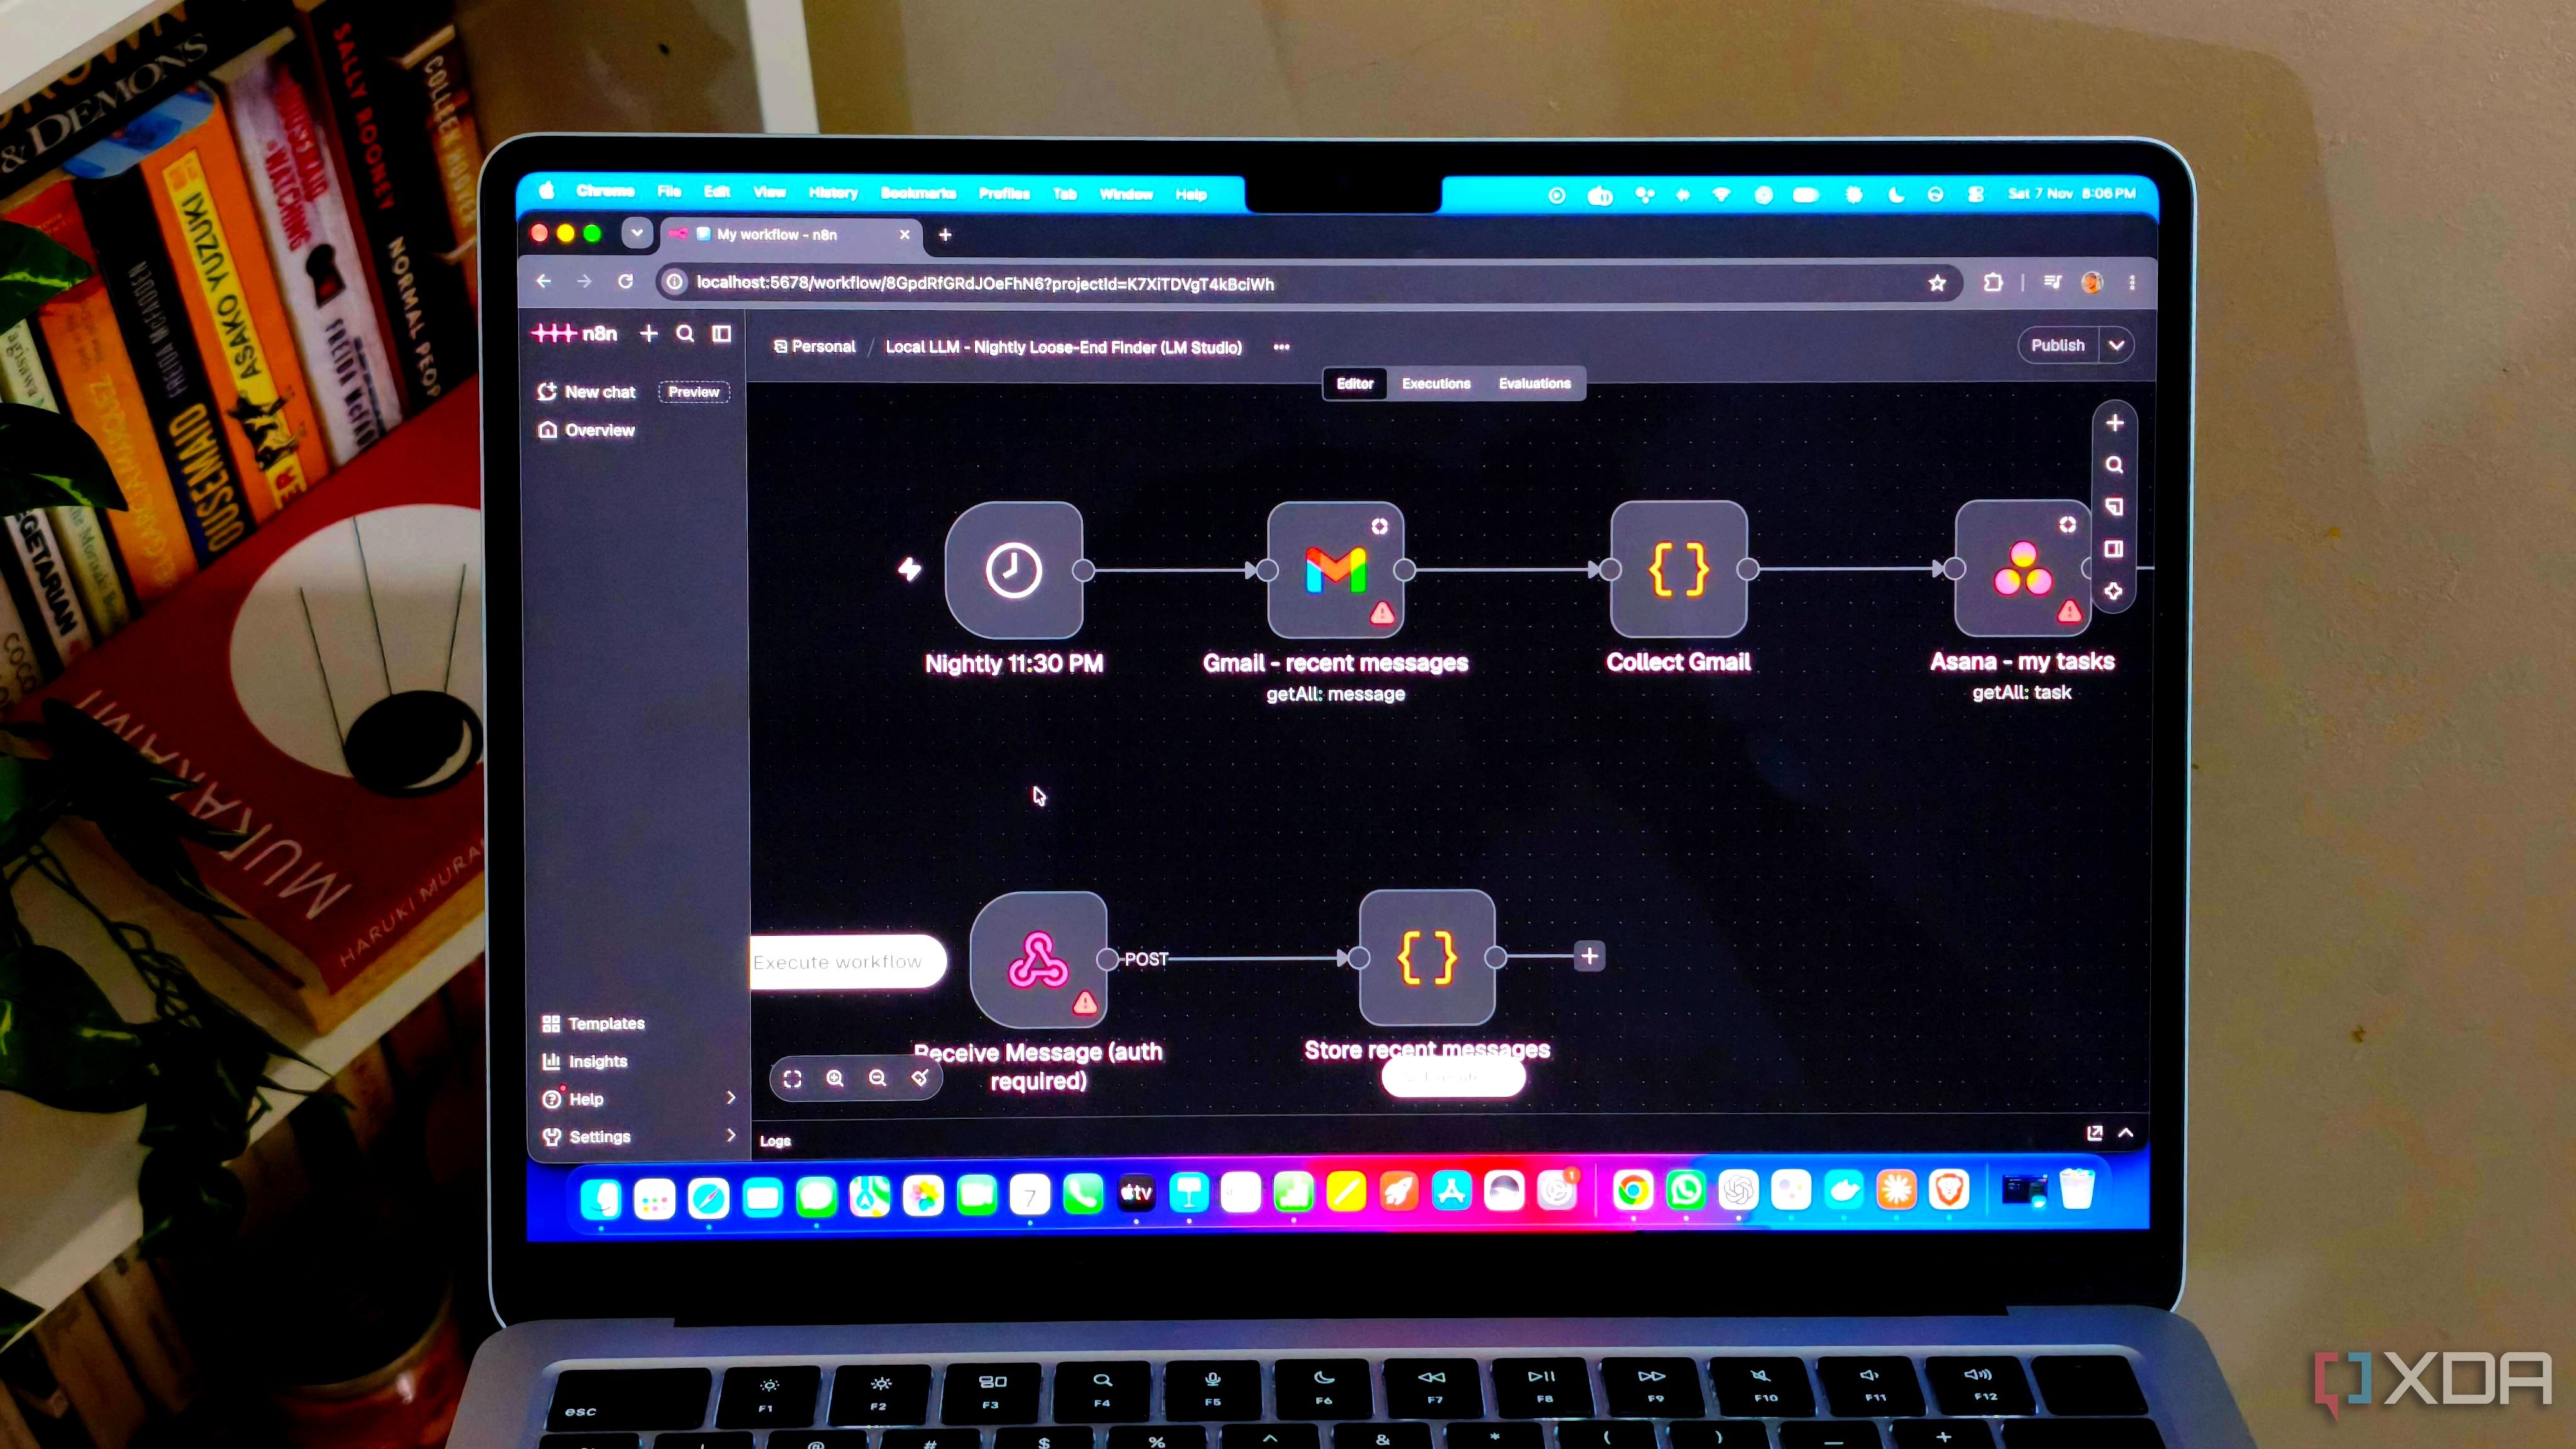
A maioria das interações com modelos de linguagem locais envolve abrir uma janela de chat, digitar um comando e aguardar uma resposta. Embora interessante, esse padrão repetitivo raramente se integra sem esforço aos fluxos de trabalho de produtividade diária sem esforço manual.
Destaques principais da configuração de automação com LLM local: - Construído usando o n8n rodando localmente em uma infraestrutura de servidor doméstico. - Impulsionado pelo modelo de linguagem Qwen 3.5 9B executado localmente. - Executa um fluxo de trabalho agendado todas as noites para agregar e-mails, mensagens e tarefas. - Entrega um briefing matinal priorizado e conciso diretamente na caixa de entrada.
Automatizando o fluxo de trabalho do briefing noturno Acompanhar compromissos espalhados por e-mails, mensagens de chat e ferramentas de gerenciamento de projetos como o Asana é um desafio constante. Acompanhamentos importantes geralmente acabam passando despercebidos simplesmente porque verificar tudo manualmente todas as noites é entediante. Para resolver isso, um fluxo de trabalho agendado foi criado no n8n para puxar informações automaticamente todas as noites. O fluxo de trabalho examina diferentes canais de comunicação para identificar respostas pendentes, prazos se aproximando e tarefas inacabadas, sem exigir nenhuma intervenção manual.
Restrições do modelo e execução segura O modelo de IA é instruído a procurar especificamente por compromissos e estruturar a saída, em vez de gerar longos parágrafos. Esse formato estruturado ajuda o n8n a analisar facilmente os dados, remover duplicatas e formatar um briefing diário limpo. Crucialmente, o fluxo de trabalho apenas relata informações e não responde automaticamente a mensagens ou modifica tarefas. Impedir que o LLM tome ações autônomas protege contra interpretações incorretas e potenciais mal-entendidos de contexto.
Por que modelos locais menores se destacam na automação Esperar que modelos locais lidem com programação complexa ou compitam diretamente com modelos massivos em nuvem geralmente leva à frustração. Modelos menores exigem ajustes frequentes nos comandos quando recebem tarefas muito amplas. No entanto, quando integrados a automações bem definidas com ferramentas específicas, os LLMs locais menores provam seu valor. Dar a eles trabalhos recorrentes e focados elimina a necessidade de comandos manuais e extrai valor prático de hardware de IA local.
Fonte: XDA