Wie ein lokaler LLM-Nachtautomatisierungsworkflow mir Stunden sparte
Das lokale Ausführen von Qwen 3.5 9B über n8n zur Verarbeitung von E-Mails und Aufgaben jede Nacht erstellt ein nützliches Morgenbriefing ganz ohne manuelle Chat-Prompts.
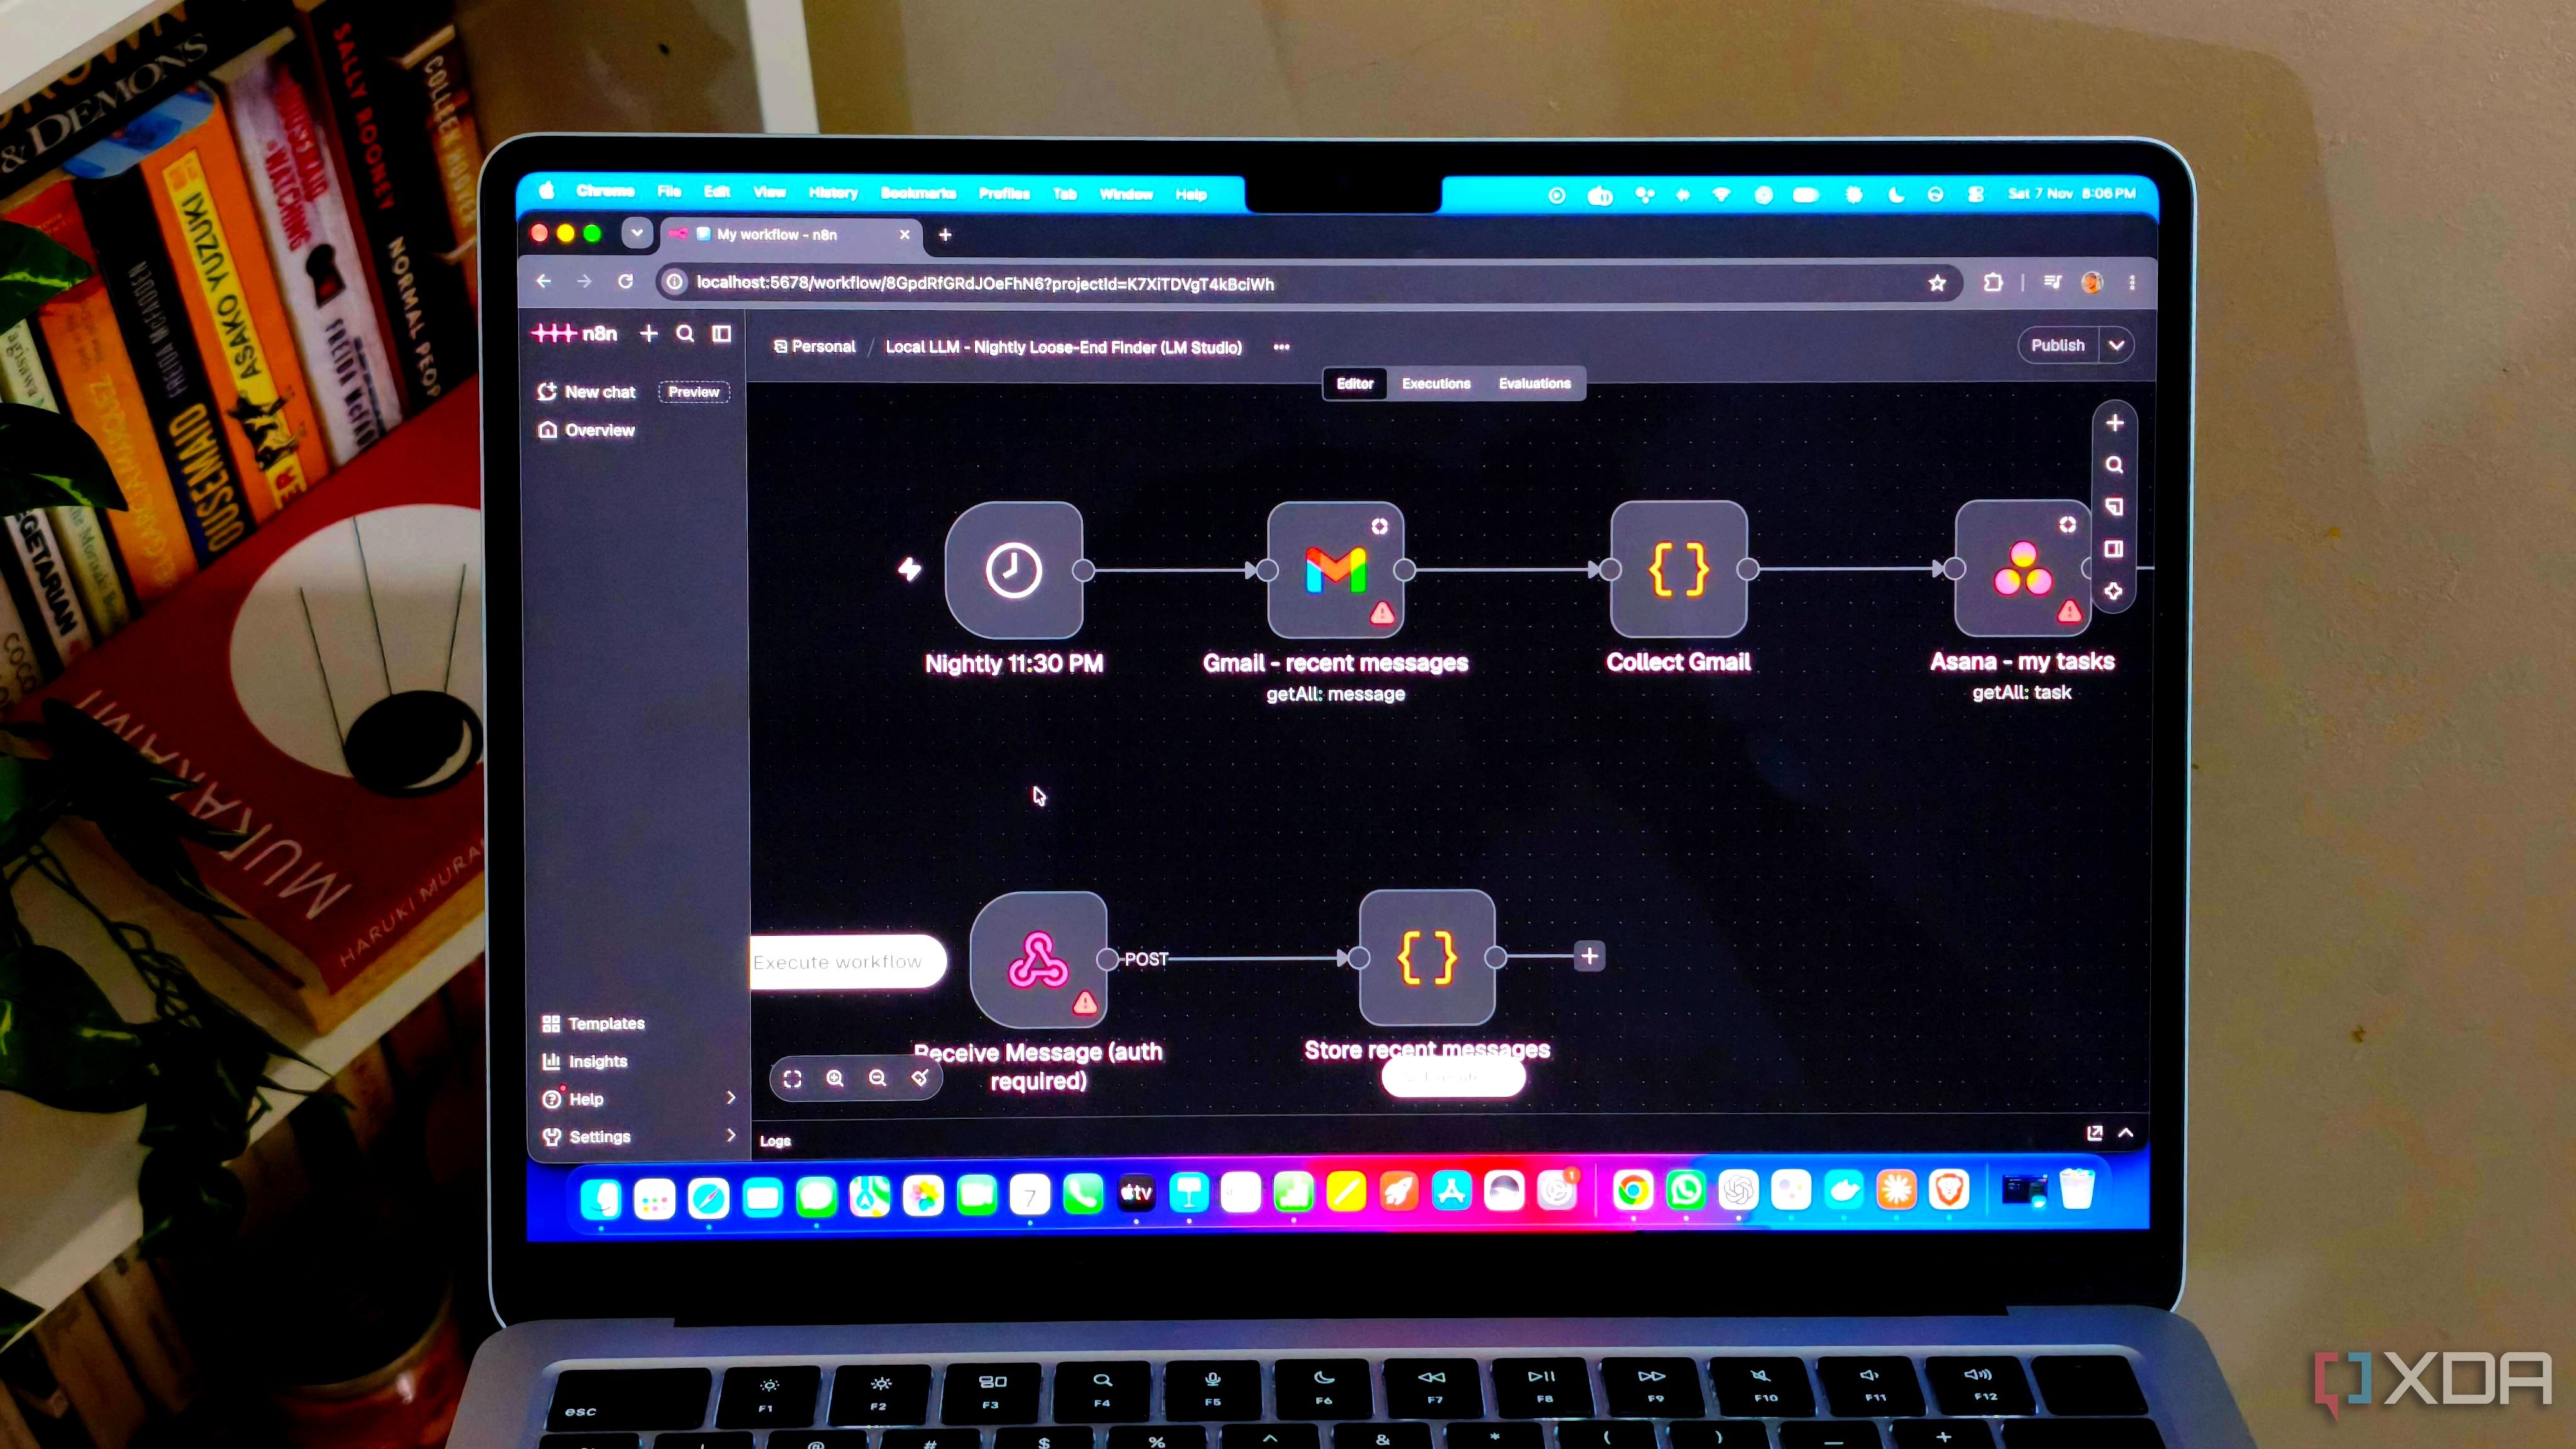
Die meisten Interaktionen mit lokalen Sprachmodellen bestehen darin, ein Chat-Fenster zu öffnen, einen Befehl einzugeben und auf eine Antwort zu warten. So interessant das auch ist, lässt sich dieses repetitive Muster selten ohne manuellen Aufwand nahtlos in tägliche Produktivitäts-Workflows integrieren.
Wichtige Highlights des lokalen LLM-Automatisierungssetups: - Erstellt mit n8n, das lokal auf einer Heimserver-Infrastruktur läuft. - Angetrieben von dem lokal ausgeführten Sprachmodell Qwen 3.5 9B. - Führt jede Nacht einen geplanten Workflow aus, um E-Mails, Nachrichten und Aufgaben zusammenzufassen. - Liefert ein priorisiertes, prägnantes Morgenbriefing direkt in den Posteingang.
Automatisierung des nächtlichen Briefing-Workflows Den Überblick über Verpflichtungen zu behalten, die über E-Mails, Chat-Nachrichten und Projektmanagement-Tools wie Asana verstreut sind, ist eine ständige Herausforderung. Wichtige Follow-ups gehen oft einfach deshalb unter, weil das manuelle Überprüfen am Abend mühsam ist. Um dieses Problem zu lösen, wurde in n8n ein zeitgesteuerter Workflow erstellt, der jede Nacht automatisch Informationen abruft. Der Workflow durchsucht verschiedene Kommunikationskanäle, um ausstehende Antworten, nahende Fristen und unvollständige Aufgaben zu identifizieren, ganz ohne manuelle Eingriffe.
Modellbeschränkungen und sichere Ausführung Das KI-Modell erhält die klare Anweisung, gezielt nach Zusagen zu suchen und die Ausgabe zu strukturieren, anstatt lange Absätze zu generieren. Dieses strukturierte Format hilft n8n dabei, die Daten problemlos zu parsen, Duplikate zu entfernen und ein übersichtliches tägliches Briefing zu formatieren. Entscheidend ist, dass der Workflow lediglich Informationen meldet und nicht automatisch auf Nachrichten antwortet oder Aufgaben ändert. Die Verhinderung autonomer Aktionen durch das LLM schützt vor Fehlinterpretationen und potenziellen Kontextmissverständnissen.
Warum kleinere lokale Modelle bei der Automatisierung glänzen Wer von lokalen Modellen erwartet, dass sie komplexe Programmierarbeiten erledigen oder direkt mit riesigen Cloud-Modellen konkurrieren, wird oft entgegengesetzt enttäuscht. Kleinere Modelle erfordern häufige Prompt-Anpassungen, wenn ihnen zu breit gefächerte Aufgaben zugewiesen werden. Wenn sie jedoch in klar definierte Automatisierungen mit spezifischen Werkzeugen integriert werden, beweisen kleinere lokale LLMs ihren Wert. Indem man ihnen wiederkehrende, fokussierte Aufgaben überträgt, entfällt die Notwendigkeit manueller Prompts und es lässt sich praktischer Nutzen aus lokaler KI-Hardware ziehen.
Quelle: XDA