Comment un flux de travail automatisé nocturne avec un LLM local m'a fait gagner des heures
Exécuter localement Qwen 3.5 9B via n8n pour traiter les e-mails et les tâches chaque nuit permet de créer un briefing matinal utile sans avoir à saisir de requêtes manuelles.
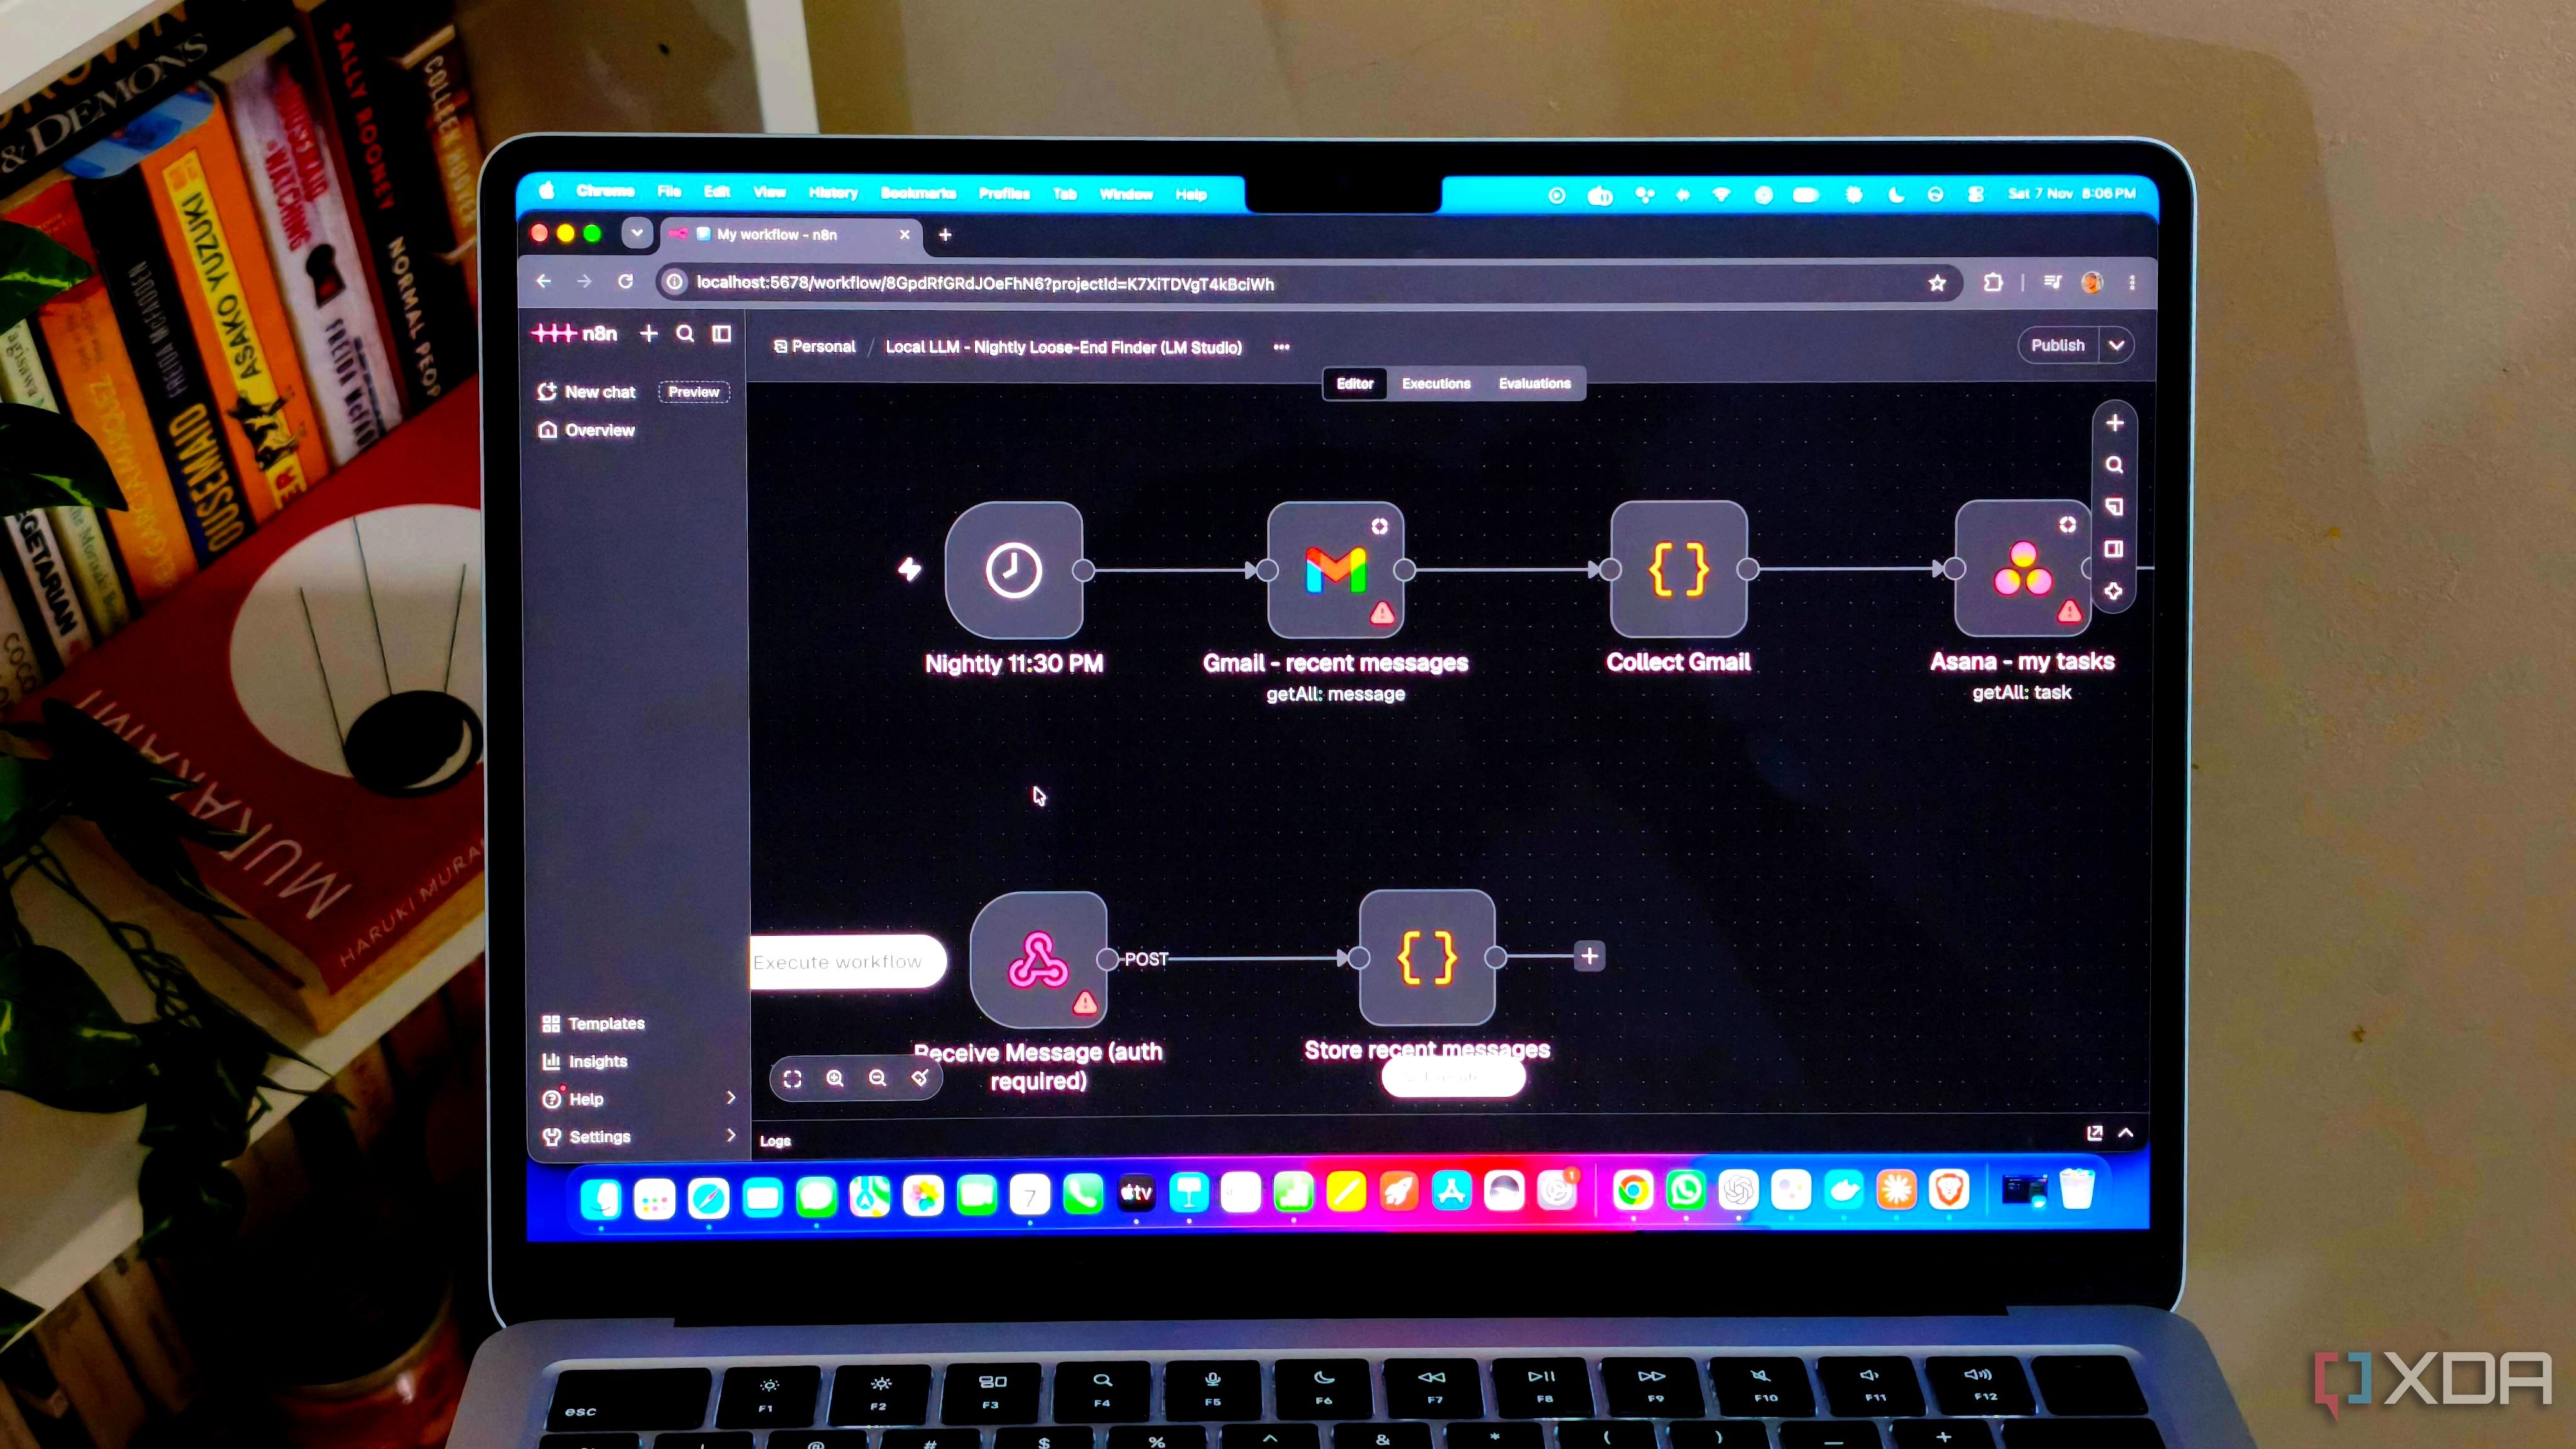
La plupart des interactions avec les modèles de langage locaux impliquent d'ouvrir une fenêtre de discussion, de taper une instruction et d'attendre une réponse. Bien qu'intéressant, ce schéma répétitif s'intègre rarement de manière fluide dans les flux de travail quotidiens sans effort manuel.
Points clés de la configuration d'automatisation avec un LLM local : - Conçu à l'aide de n8n exécuté localement sur une infrastructure de serveur domestique. - Propulsé par le modèle de langage Qwen 3.5 9B fonctionnant en local. - Exécute un flux de travail planifié chaque nuit pour agréger les e-mails, messages et tâches. - Fournit un briefing matinal concis et hiérarchisé directement dans la boîte de réception.
Automatisation du flux de travail pour le briefing nocturne Il est toujours difficile de suivre les engagements dispersés dans les e-mails, les messages instantanés et les outils de gestion de projet comme Asana. Les suivis importants passent souvent à la trappe simplement parce qu'il est fastidieux de tout vérifier manuellement chaque soir. Pour résoudre ce problème, un flux de travail planifié a été créé dans n8n afin de récupérer automatiquement les informations chaque nuit. Le flux analyse différents canaux de communication pour identifier les réponses en attente, les échéances proches et les tâches inachevées, le tout sans intervention humaine.
Contraintes du modèle et exécution sécurisée Le modèle d'IA reçoit pour instruction de rechercher spécifiquement les engagements et de structurer le résultat plutôt que de rédiger de longs paragraphes. Ce format structuré aide n8n à analyser facilement les données, à éliminer les doublons et à mettre en forme un briefing quotidien propre. Fait crucial, le flux de travail se contente de signaler les informations et ne répond pas automatiquement aux messages et ne modifie pas les tâches. Empêcher le LLM d'entreprendre des actions de manière autonome protège contre les erreurs d'interprétation et les éventuels malentendus contextuels.
Pourquoi les petits modèles locaux brillent dans l'automatisation S'attendre à ce que les modèles locaux gèrent des programmations complexes ou rivalisent directement avec les modèles cloud massifs mène souvent à la déception. Les petits modèles nécessitent des ajustements fréquents des instructions lorsqu'on leur confie des tâches trop vastes. Cependant, lorsqu'ils sont intégrés dans des automatisations bien définies dotées d'outils spécifiques, les petits LLM locaux prouvent leur valeur. Le fait de leur confier des tâches récurrentes et ciblées élimine le besoin de requêtes manuelles et permet de tirer un réel parti pratique du matériel d'IA local.
Source: XDA