Jak lokalna nocna automatyzacja z użyciem LLM oszczędziła mi godziny pracy
Uruchamianie lokalnie modelu Qwen 3.5 9B za pomocą n8n do przetwarzania e-maili i zadań każdej nocy pozwala uzyskać użyteczny poranny brief bez konieczności wpisywania ręcznych promptów.
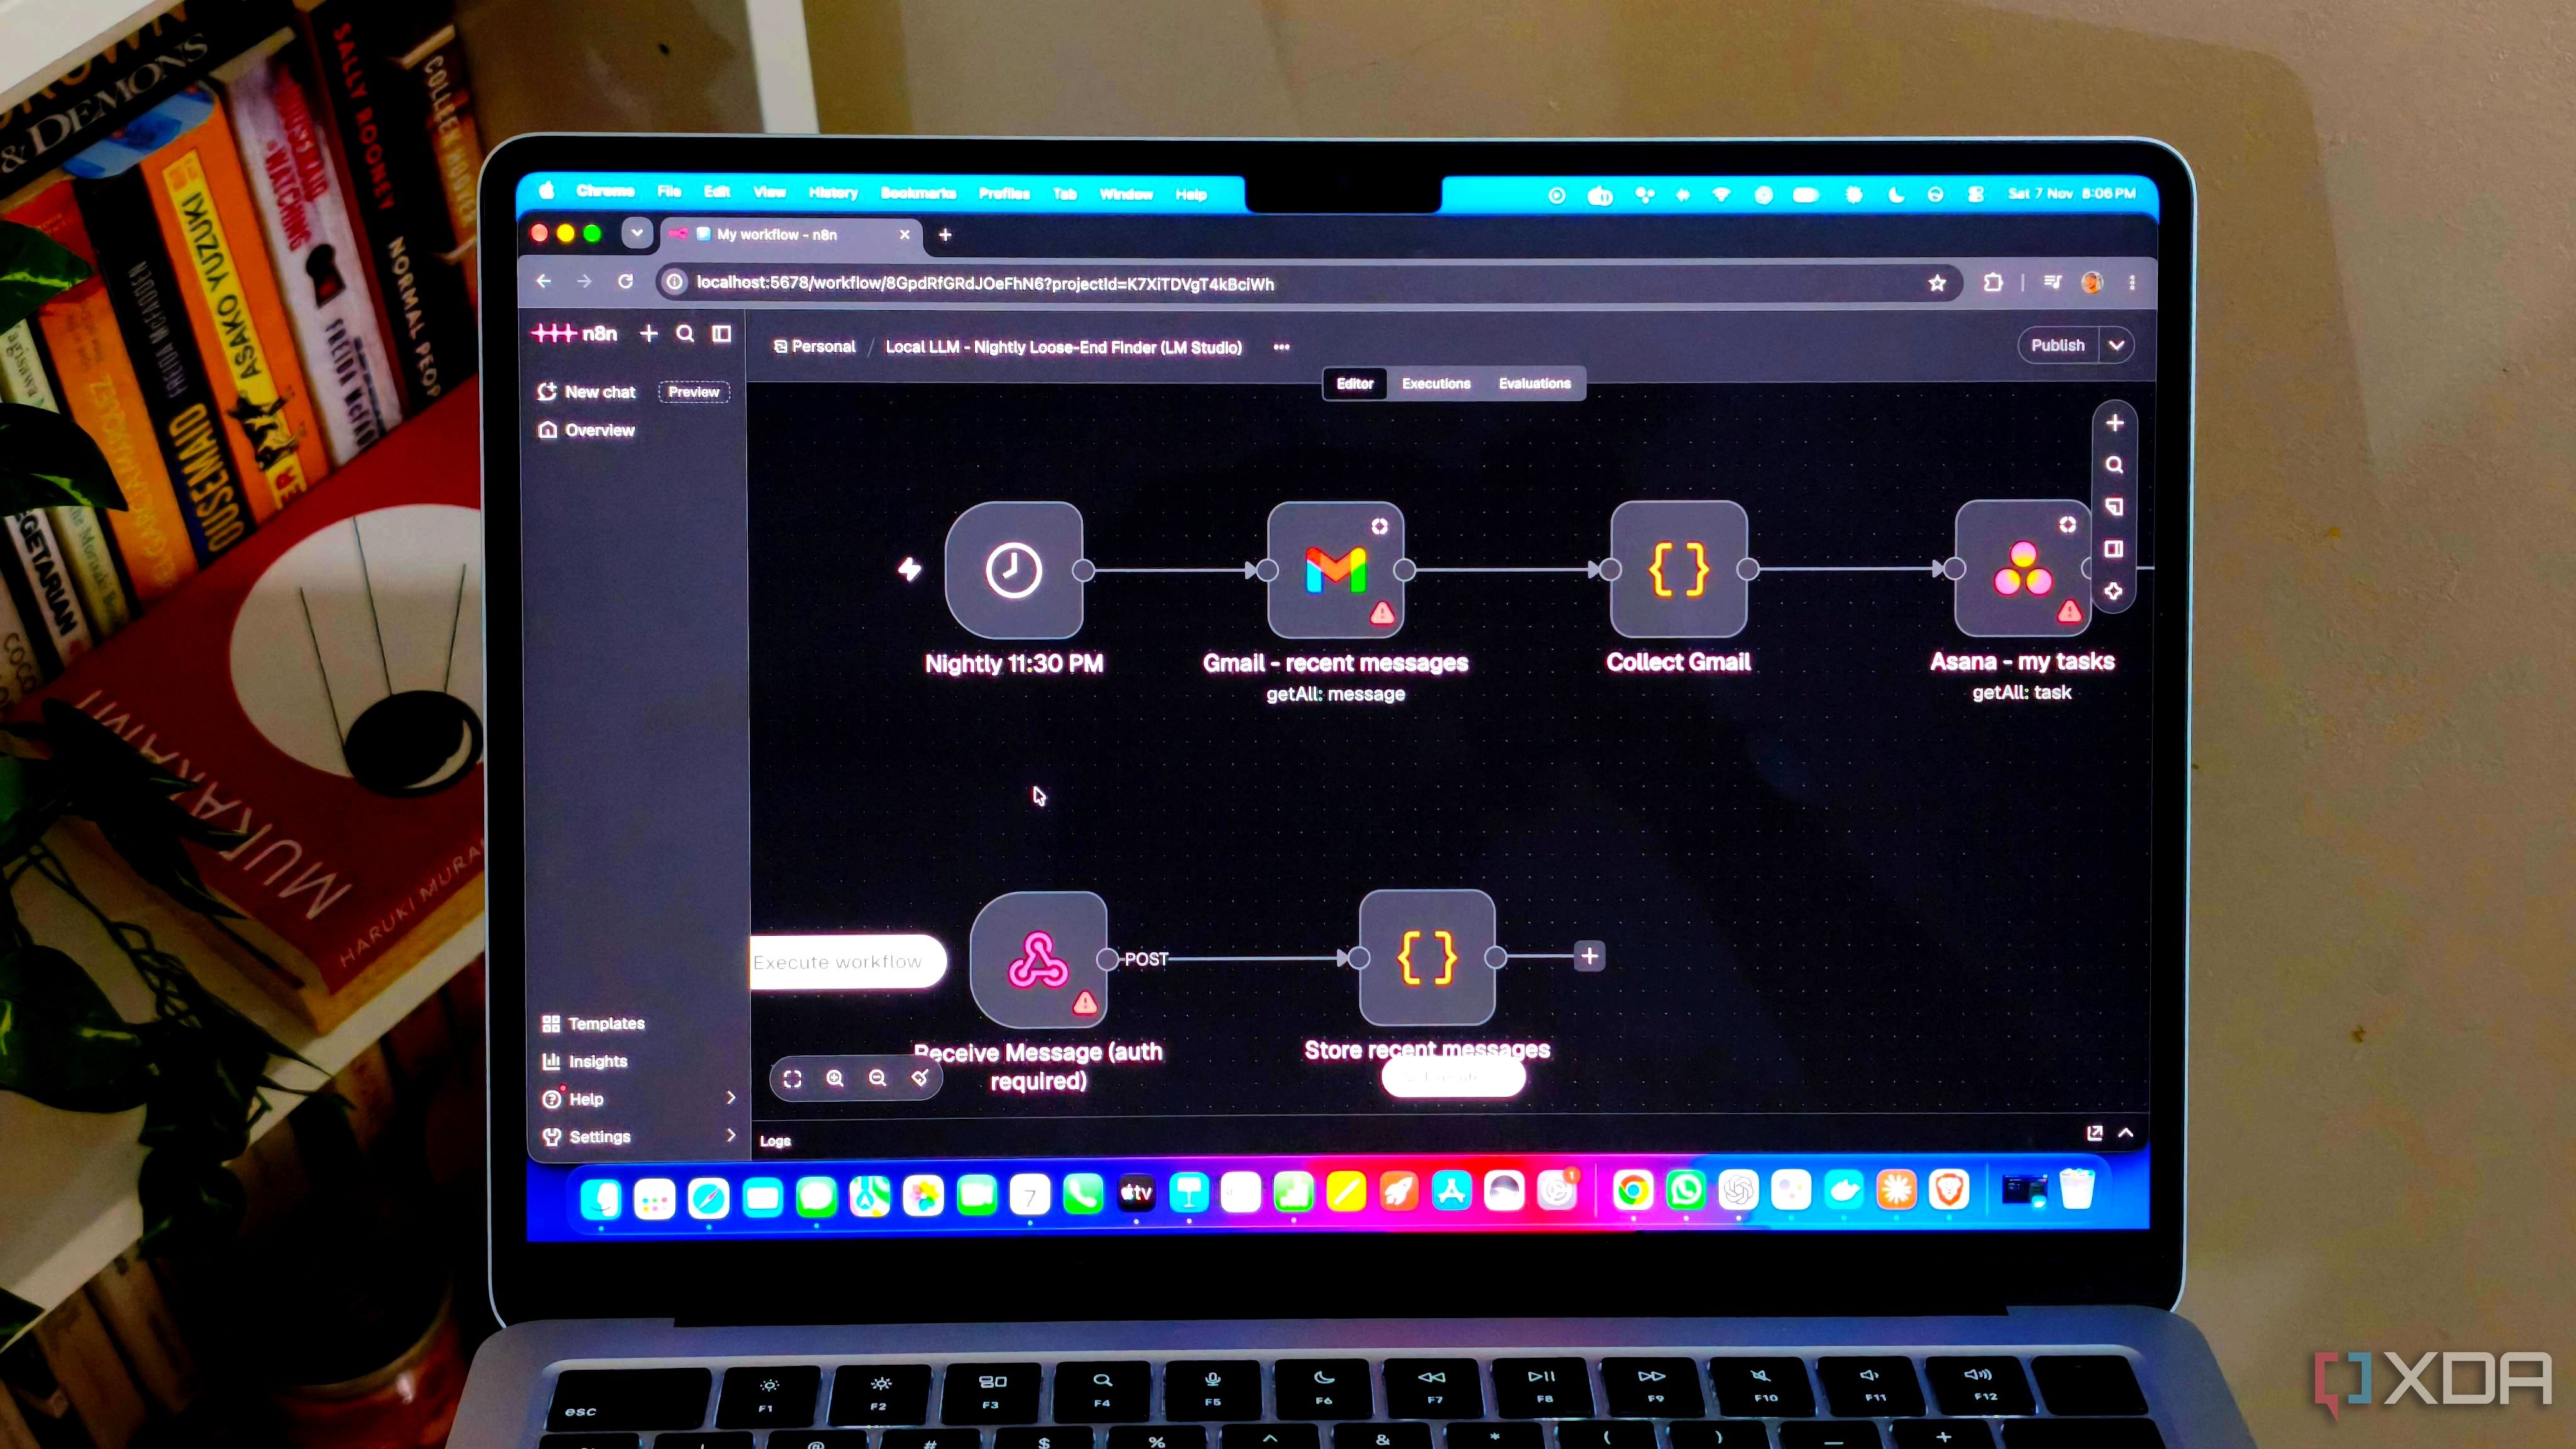
Większość interakcji z lokalnymi modelami językowymi wiąże się z otwarciem okna czatu, wpisaniem polecenia i oczekiwaniem na odpowiedź. Choć to ciekawe, ten powtarzalny schemat rzadko bezproblemowo integruje się z codziennymi nawykami produktywnymi bez wysiłku ze strony użytkownika.
Kluczowe aspekty lokalnej konfiguracji automatyzacji z LLM: - Zbudowana przy użyciu n8n uruchomionego lokalnie na infrastrukturze domowego serwera. - Napędzana przez model językowy Qwen 3.5 9B działający lokalnie. - Wykonuje zaplanowany przepływ pracy każdej nocy, agregując wiadomości e-mail, wiadomości komunikatorów i zadania. - Dostarcza priorytetyzowany, zwięzły poranny brief bezpośrednio do skrzynki odbiorczej.
Automatyzacja nocnego przepływu pracy z briefem Śledzenie zobowiązań rozproszonych po e-mailach, wiadomościach czatu i narzędziach do zarządzania projektami, takich jak Asana, to ciągłe wyzwanie. Ważne kwestie do ponownego rozpatrzenia często umykają po prostu dlatego, że codzienne wieczorne sprawdzanie wszystkiego ręcznie jest nużące. Aby to rozwiązać, w n8n stworzono zaplanowany przepływ pracy, który automatycznie pobiera informacje każdej nocy. System skanuje różne kanały komunikacji, aby zidentyfikować oczekujące odpowiedzi, zbliżające się terminy i niedokończone zadania bez konieczności jakiejkolwiek ręcznej interwencji.
Ograniczenia modelu i bezpieczne wykonywanie Model sztucznej inteligencji ma za zadanie szukać konkretnie zobowiązań i strukturyzować dane wyjściowe, zamiast generować długie akapity. Ten uporządkowany format pomaga n8n w łatwym parsowaniu danych, usuwaniu duplikatów i formatowaniu przejrzystego codziennego podsumowania. Co kluczowe, przepływ pracy jedynie raportuje informacje i nie odpowiada automatycznie na wiadomości ani nie modyfikuje zadań. Powstrzymanie LLM przed podejmowaniem autonomicznych działań chroni przed błędnymi interpretacjami i potencjalnymi nieporozumieniami kontekstowymi.
Dlaczego mniejsze modele lokalne sprawdzają się w automatyzacji Oczekiwanie, że modele lokalne poradzą sobie ze złożonym programowaniem lub będą bezpośrednio konkurować z masywnymi modelami w chmurze, często prowadzi do rozczarowania. Mniejsze modele wymagają częstych poprawek promptów, gdy powierza się im zbyt ogólne zadania. Jednak po zintegrowaniu z dobrze zdefiniowanymi automatyzacjami wyposażonymi w konkretne narzędzia, mniejsze lokalne LLM udowadniają swoją wartość. Przydzielenie im powtarzalnych, ukierunkowanych zadań eliminuje potrzebę ręcznego wpisywania promptów i uwalnia praktyczną wartość z lokalnego sprzętu AI.
Źródło: XDA