Встроенные ИИ-оценщики не станут простым решением, считает директор по политике Hugging Face
Ирина Солайман из Hugging Face заявила, что методы бенчмаркинга искусственного интеллекта сложны и все еще находятся на этапе становления.
Лаборатории искусственного интеллекта сделали своей репутацией бенчмаркинг моделей — предположительно нейтральную и точную систему оценок, предназначенную для измерения того, какой ИИ лучше другого.
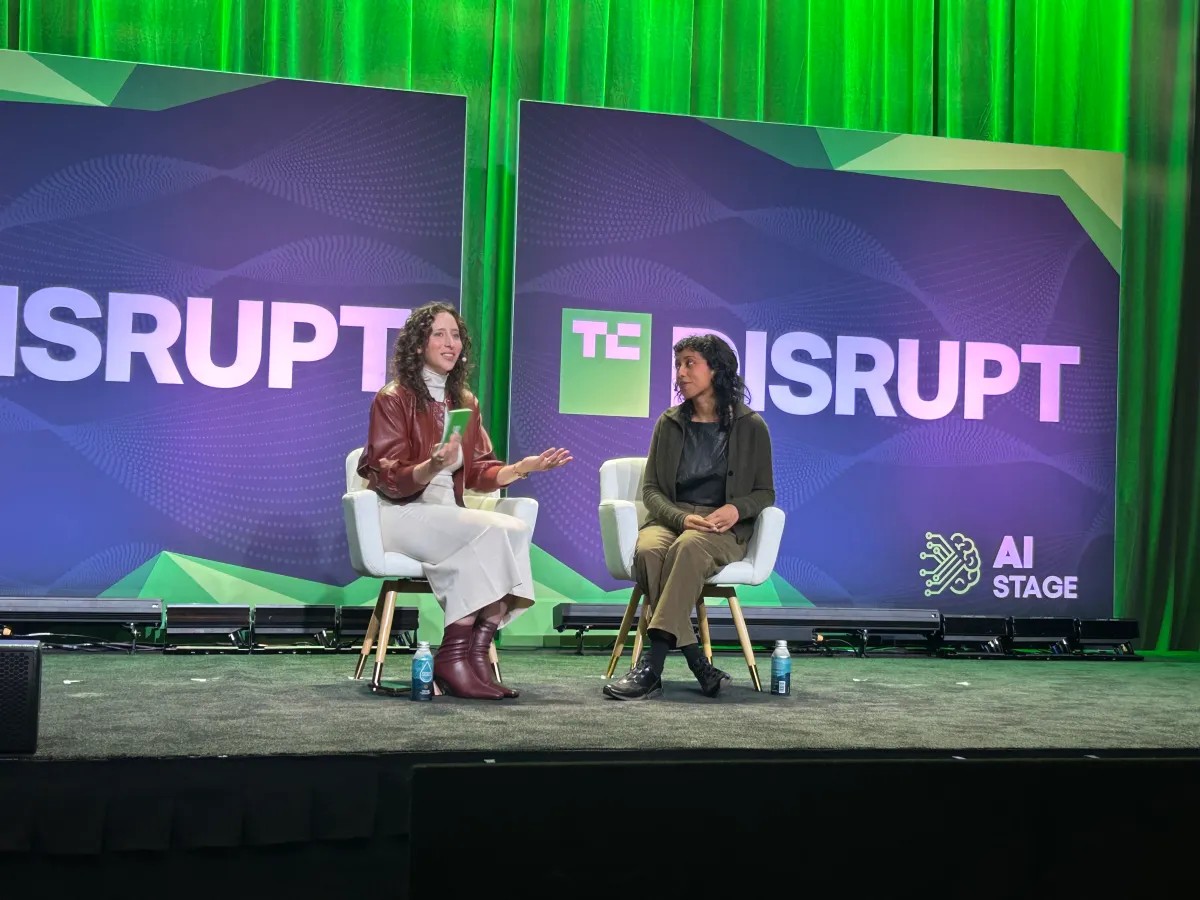
Однако методы, лежащие в основе этих оценок, сложны и все еще развиваются, заявила Ирина Солайман, директор по политике Hugging Face, во время дискуссии на TechCrunch.
В условиях стремительного развития технологий искусственного интеллекта во всем мире объективное и точное измерение возможностей моделей остается одной из ключевых задач индустрии.
Сложность создания универсальных и надежных оценщиков показывает, что индустрии еще предстоит пройти большой путь к выработке единых стандартов тестирования.
Для IT-сообщества и специалистов из развивающихся рынков понимание этих нюансов важно при выборе и внедрении готовых моделей для локальных проектов и бизнес-решений.