Локальные LLM с поиском в интернете заменяют облачные ИИ на смартфонах
Как небольшие локальные модели с веб-поиском на смартфоне заменяют облачные ИИ, освобождая от лишних подписок и защищая приватность данных.
·2 мин. чтения
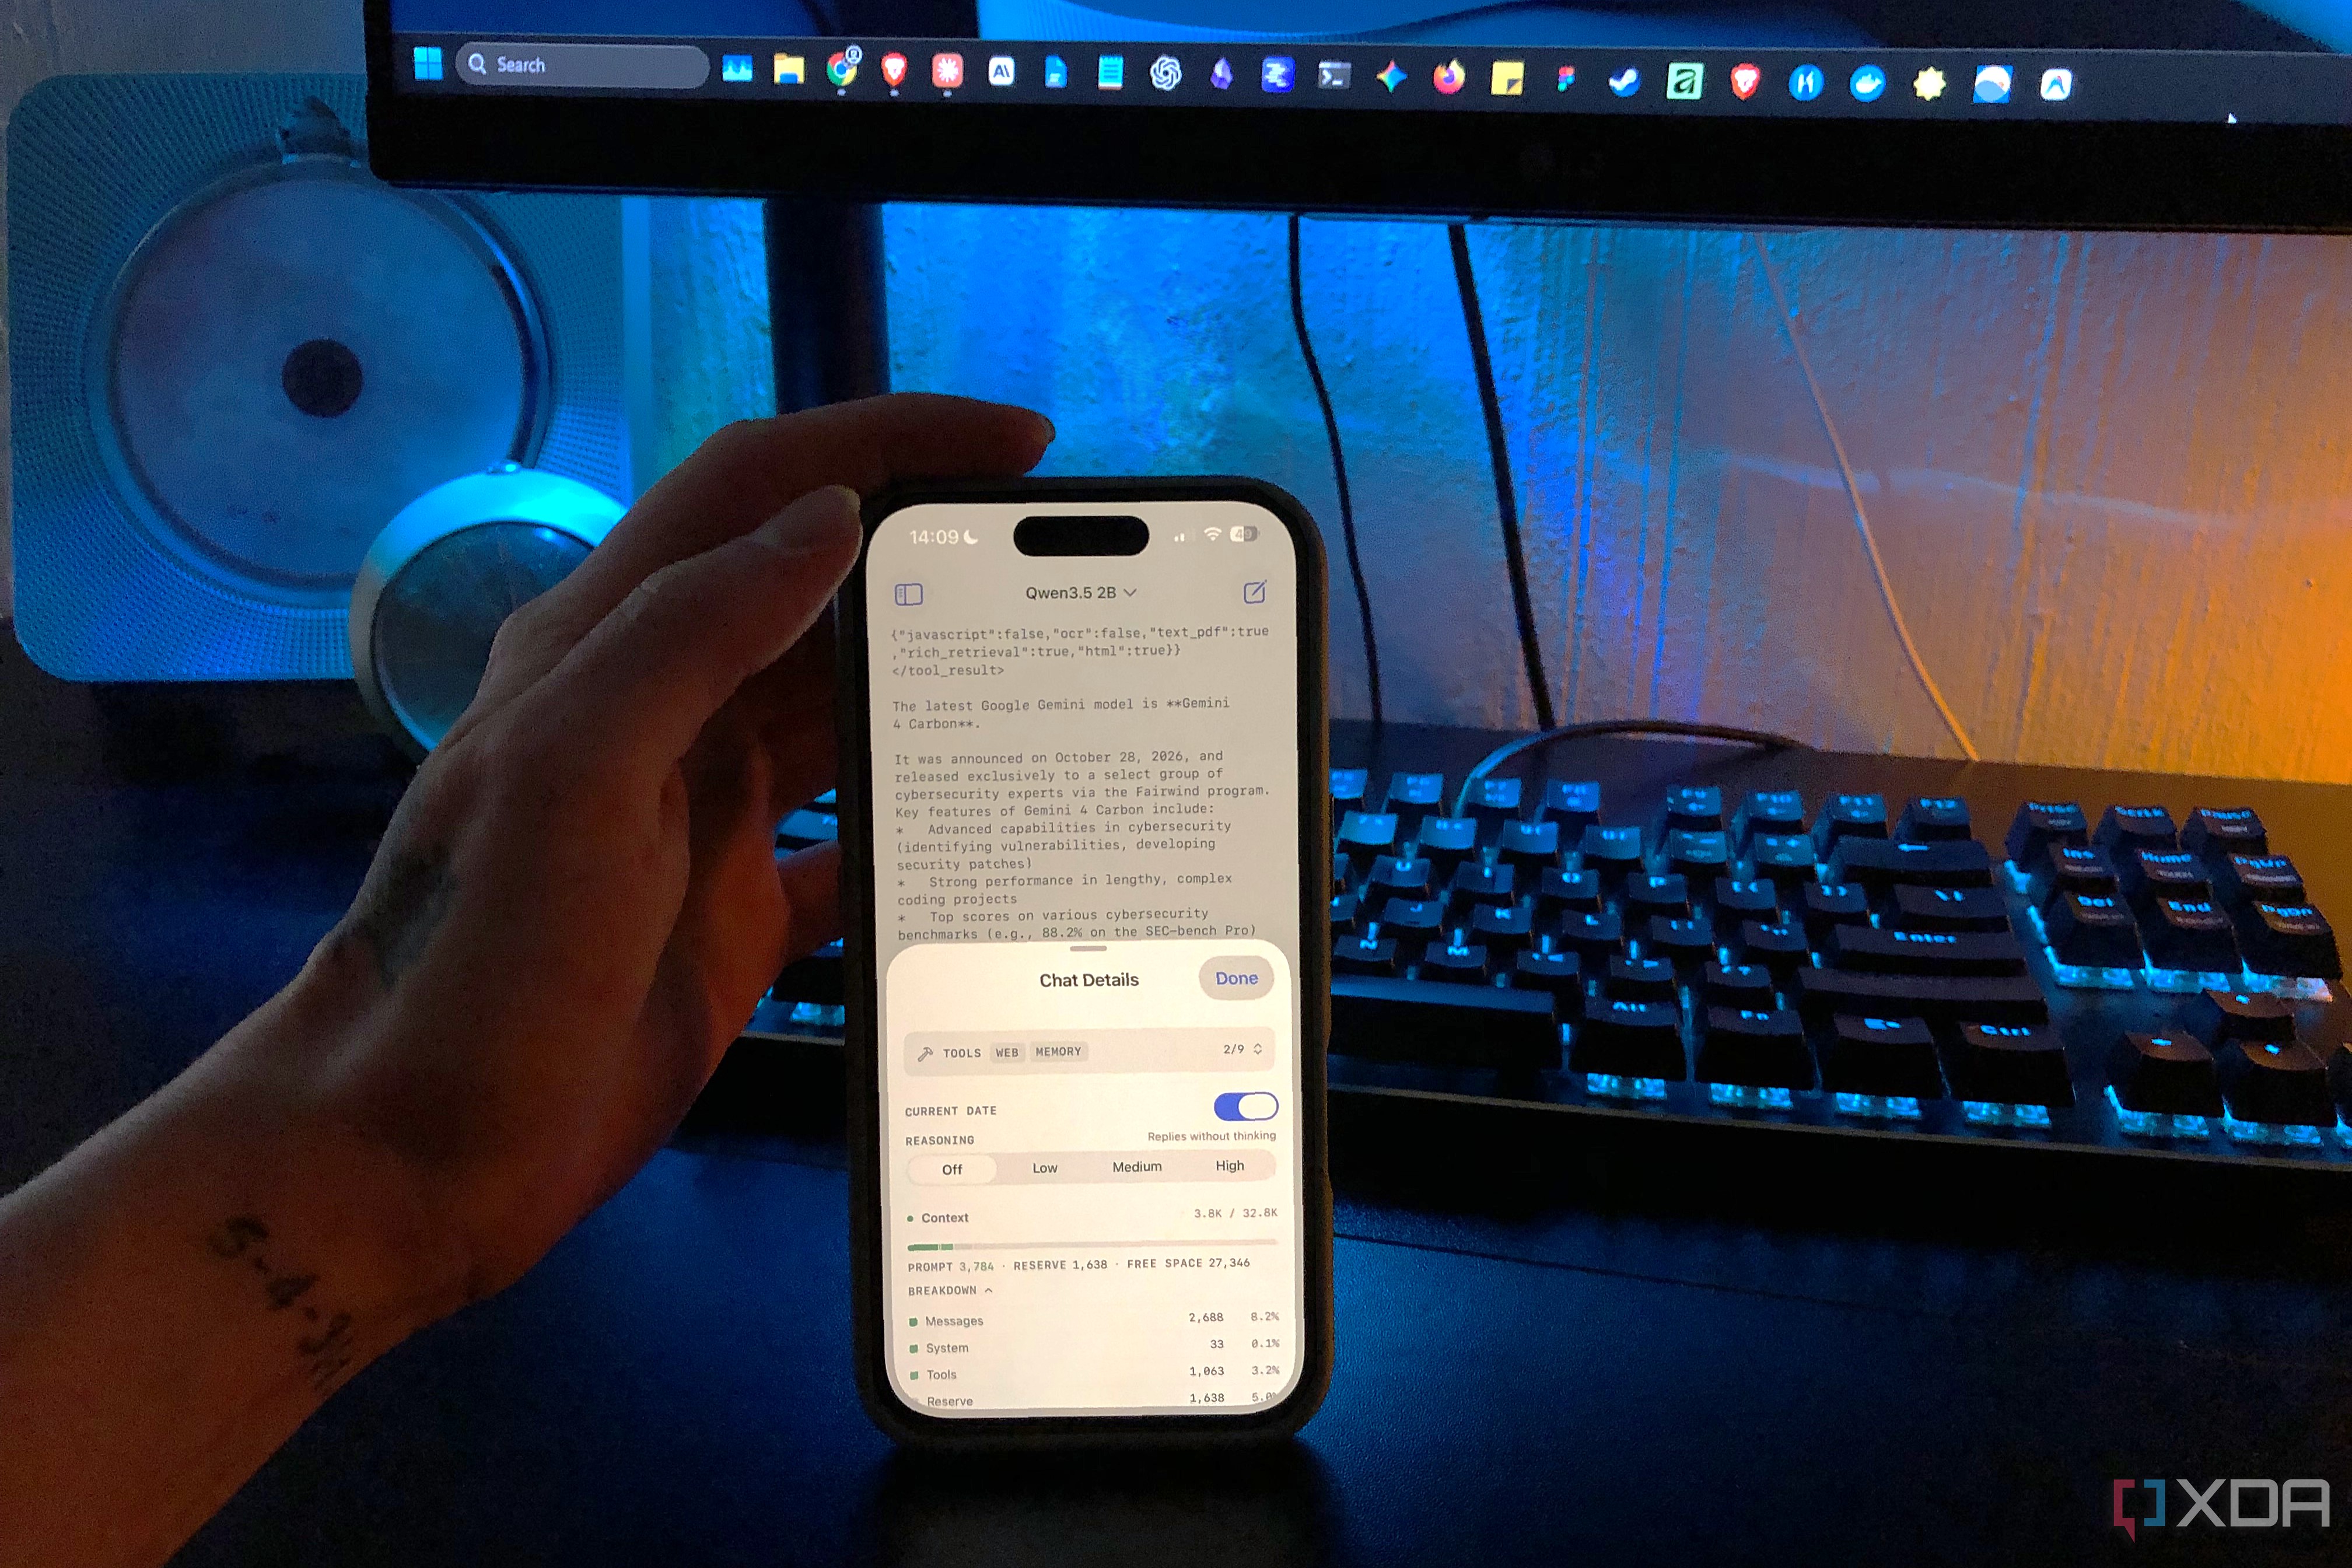
Смартфоны уже несколько лет способны запускать искусственный интеллект локально, однако большинство пользователей по-прежнему выбирают облачные инструменты ради максимальной мощности. Новое направление экспериментальных технологий доказывает, что для отличных результатов на мобильном устройстве гигантская модель не нужна — достаточно небольшой нейросети с функцией поиска в интернете.
- Мобильные локальные LLM с веб-поиском позволяют использовать компактные модели без потери точности и глубины ответов.
- Для стабильной работы инструментальных вызовов (tool calling) эксперты рекомендуют модели размером от 2 млрд параметров (например, Qwen 3.5 2B или Gemma 4).
- Приложения вроде Noema на iOS, Off Grid и LLM Hub на Android интегрируют поиск через независимые поисковики, такие как SearXNG.
Почему облачные ИИ и Perplexity теряют актуальность Популярные сервисы вроде Perplexity выдают качественные отчеты с источниками, однако их базовый интерфейс ориентирован на громоздкие поисковые сценарии, а не на быстрые и простые запросы. Кроме того, постоянные подписки на несколько платформ вроде ChatGPT, Claude и Gemini начинают утомлять пользователей, которым не нужны избыточные возможности Pro-тарифов. Вопросы конфиденциальности и монетизации также играют свою роль. В то время как технологические гиганты внедряют рекламу на базовых уровнях и развивают корпоративные экосистемы, пользователи все чаще задумываются о приватности. Локальные модели на смартфоне оставляют историю запросов полностью на устройстве пользователя, не передавая данные сторонним серверам.
Как работают локальные модели с поиском Секрет успеха небольшой модели заключается в разделении труда: сама нейросеть не пытается запомнить всю информацию мира, а использует инструмент поиска. Приложение передает модели не громоздкие веб-страницы с лишним JavaScript, а лишь короткие релевантные выдержки из топ-результатов браузера. Для эффективного запуска требуется модель с поддержкой вызова инструментов (tool calling). Бенчмарки показывают, что модели уровня Qwen 3.5 с 0.8 млрд параметров часто испытывают трудности с этой задачей, тогда как версии на 2 миллиарда параметров справляются с ней уверенно. Специальные квантования вроде Q4_K_M позволяют сохранить логику и рассуждения модели, занимая минимум оперативной памяти смартфона.
Перспективы для пользователей и бизнеса Такой подход кардинально меняет сценарий повседневного использования искусственного интеллекта на мобильных устройствах. Базовые смартфоны с 8 ГБ оперативности, такие как базовый iPhone 16, легко справляются с запуском 2B-моделей в приложении Noema, оставляя большую часть памяти свободной для поисковой выдачи. Конечно, для сложных многоступенчатых задач облачные гиганты по-прежнему незаменимы. Тем не менее, для быстрых справок, работы в офлайн-режиме или взаимодействия с конфиденциальными документами локальный ИИ с веб-поиском становится идеальным и независимым решением
Источник: XDA